DreamFuser: Value-guided Diffusion Policy for Offline Reinforcement Learning
A trajectory-based value optimization approach that combines diffusion policy learning with efficient Q-function learning for offline reinforcement learning.
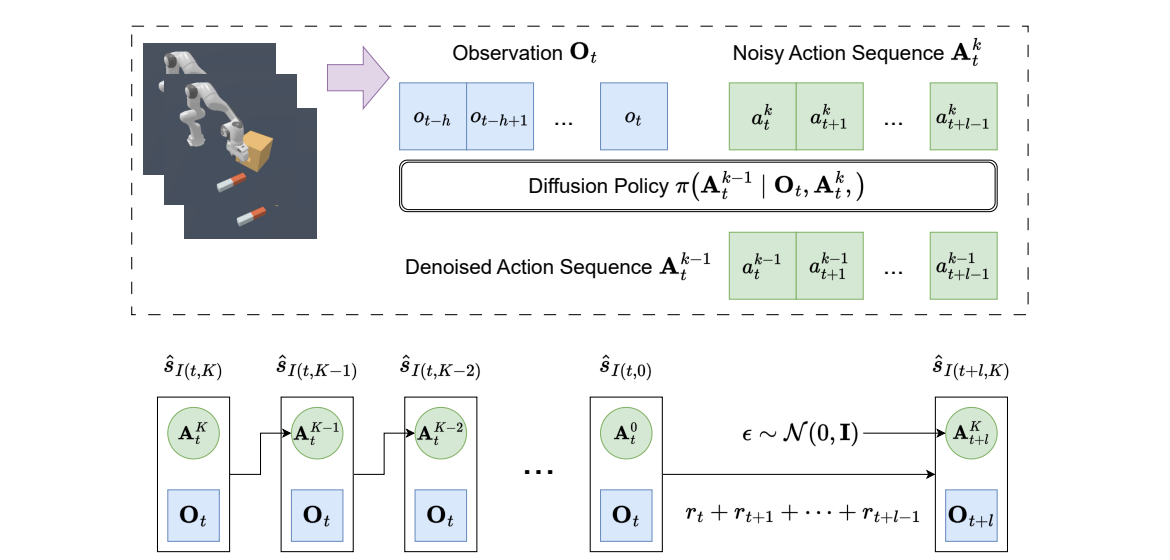
DreamFuser is a trajectory-based value optimization approach that integrates diffusion-based trajectory learning with efficient Q-function learning. It addresses computational challenges in action sampling during training by leveraging the Generalized Noisy Action Markov Decision Process (GNMDP), which treats the diffusion denoising process as part of the MDP transition.
Kairong Luo, Caiwei Xiao, Zhiao Huang, Zhan Ling, Yunhao Fang, and Hao Su. (2023). "DreamFuser: Value-guided Diffusion Policy for Offline Reinforcement Learning." Preprint.